Join real people.
You are not alone.
Your data stays inside.
Now it is your turn.
Modelos de Distribución de Especies con Estadística Bayesiana en R
Details
| Date & time | Mar 21 '22 |
| Ends on | Mar 25 '22 |
| Location | Madrid, Community of Madrid, Spain |
| Creator | LouiseLHarris |
| Category | conference |
| Registration | Link |
Who's attending
 Basic
Description
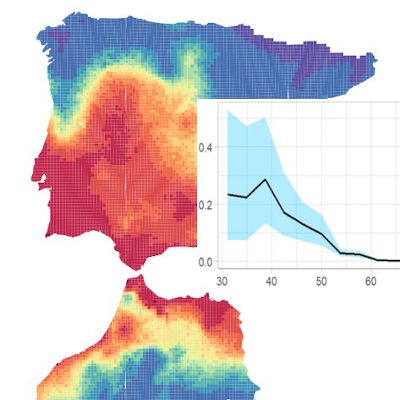 Este curso se impartirá mediante una combinación de sesiones en directo (sincrónicas) en Zoom, con ejercicios a realizar entre las clases en directo.
Las sesiones en directo se grabarán y estarán disponibles para los participantes durante un período de tiempo limitado. Aún así se requiere la asistencia a las sesiones en vivo, ya que este curso es principalmente práctico
Los árboles de regresión aditivos bayesianos (BART, Bayesian Additive Regression Trees) son un método de aprendizaje automático o aprendizaje de máquinas (machine learning) con aplicaciones muy prometedoras en el modelado de distribución de especies basado en datos de presencia y ausencia de observaciones.
A diferencia de la mayoría de métodos, la capacidad predictiva de BART suele mostrar un buen equilibrio entre los dos aspectos principales de la evaluación de modelos: la discriminación (que implica distinguir las localidades con presencia de las demás) y la calibración (que implica que la probabilidad de presencia refleje la variación gradual en la frecuencia de ocurrencia de la especie).
Los BART generan predicciones acertadas sin sobreajustarse al ruido ni a casos particulares en los datos. En este curso se explicará:
1) Una introducción o repaso sobre modelos de nicho ecológico y modelos de distribución de especies
2) La construcción de modelos de diferente complejidad, incluyendo métodos de regresión estadística y métodos de aprendizaje de máquinas (tanto bayesianos como no bayesianos)
3) Validación cruzada y comparación de los modelos enfocando varios aspectos de su capacidad predictiva, en particular la discriminación y la calibración o fiabilidad
4) La identificación de variables relevantes, curvas y mapas de respuesta parcial, y predicciones con intervalos de confianza y niveles de incertidumbre. Las prácticas se harán en R, utilizando paquetes como ’embarcadero’, ‘fuzzySim’, ‘blockCV’ y ‘modEvA’.
Durante el curso, los participantes podrán aplicar estas técnicas a sus propios datos de presencia de especies, o si no los tienen a datos de ejemplo que serán proporcionados por la profesora.
Haz clic aquí para ver el programa completo
RequerimientosLos participantes deben tener un ordenador (Windows, Linux, Macintosh), preferiblemente con webcam, y una buena conexión a internet. Se requiere conocimiento básico de R.
Español
Sesiones en línea en directo del lunes a viernes de 15:00 a 19:00 (Zona horaria de Madrid).
4 horas diarias adicionales para las prácticas, con scripts preparados y con asistencia remota de la instructora a través de Slack, entre las 9 y las 23h (zona horaria de Madrid).
Es importante tener en cuenta que para poder seguir el curso se necesita una dedicación de 7 horas diarias.
Total: 35 horas
Plazas
La capacidad del curso es de 18 participantes, que se ocuparán por estricto orden de inscripción.
Los participantes que completen el curso recibirán un certificado a la finalización del mismo.

The Wall